L’IA et l’environnement : quatre chiffres qui circulent, et ce qu’ils ne disent pas
Une fiche pédagogique met en circulation quatre ordres de grandeur sur l'empreinte environnementale de l'intelligence artificielle. Ils sont utiles : ils donnent à voir une trajectoire que peu de dossiers d'entreprise chiffrent. Trois d'entre eux demandent une précision avant d'être repris — non parce qu'ils seraient faux, mais parce qu'ils ne disent pas leur périmètre.
Ce que la fiche avance
Électricité — consommation mondiale des centres de données : 485 TWh en 2025, soit l'équivalent de la consommation annuelle de la France, et 945 TWh en 2030, soit celle du Japon.
Eau — de 4 500 à 9 300 milliards de litres par an entre 2025 et 2030, présentés comme l'équivalent des besoins de 1,3 milliard de personnes.
Carbone d'entraînement — 552, puis 25 000, puis 42 000 tonnes de CO₂e pour GPT-3, GPT-4 et GPT-5 : un facteur 76 en cinq ans.
Usage quotidien — la consommation journalière maximale de ChatGPT en 2025, sur la base de 2,5 milliards de requêtes par jour, rapportée à celle de 3,9 millions de foyers français. Et cette conclusion : 80 à 90 % des impacts viennent de l'usage, non de l'entraînement.
L'électricité : une trajectoire, pas une mesure
Le chiffre de 945 TWh à l'horizon 2030 est celui que l'Agence internationale de l'énergie publie dans son rapport Energy and AI, au titre de son scénario de référence ; la fiche le rattache à un autre éditeur, ce qui mérite d'être vérifié avant citation. Un scénario n'est pas une mesure : il vaut par ses hypothèses, et celles-ci se révisent.
Comparer un secteur à un pays donne à voir un ordre de grandeur ; cela ne dit ni où cette électricité est produite, ni avec quel contenu carbone. Deux repères que nous tenons, pour la France : l'Arcep relève une hausse de 23 % des émissions de la filière à fin 2024, et la commission d'enquête parlementaire sur les vulnérabilités numériques fait état de 15 GW déjà réservés auprès de RTE pour des centres de données, dont 1,4 GW portés par des acteurs européens. Une réservation de raccordement n'est ni une puissance installée ni une consommation : elle mesure une intention, et une part inconnue n'aboutira pas.
L'eau : le chiffre publié est presque toujours celui du site — et il manque l'essentiel
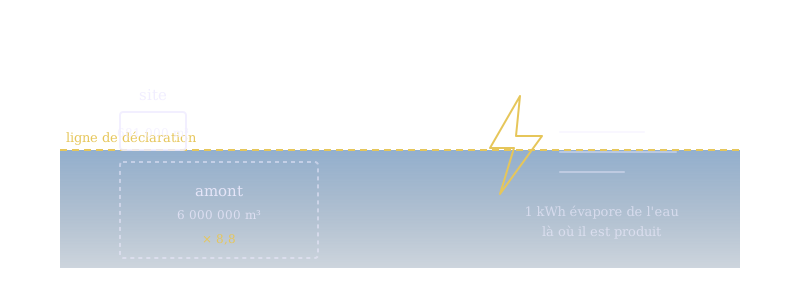
C'est le point sur lequel notre référentiel apporte le plus. Le volume d'eau qu'un centre de données publie est celui qu'il prélève sur son site : c'est ce qu'exige le règlement délégué (UE) 2024/1364, et c'est ce que compare la presse. Il ignore l'eau consommée en amont pour produire son électricité — les tours aéroréfrigérantes des centrales en évaporent.
Deux relevés indépendants, une même conclusion. Sur le parc français déclarant en 2023, l'Arcep mesure 681 000 m³ sur site contre 6 000 000 m³ en amont : un rapport de près de neuf. Sur le parc états-unien la même année, le Lawrence Berkeley National Laboratory relève 64 millions de m³ sur site contre 800 millions en amont : un rapport de plus de douze. L'ordre de grandeur ne tient donc ni à un pays ni à un mix électrique.
Un total mondial qui ne précise pas s'il compte l'amont peut ainsi se tromper d'un ordre de grandeur, et toujours dans le même sens. Le piège est technique autant que comptable : un centre qui remplace son refroidissement évaporatif par un refroidissement sec affiche un WUE de site nul — tout en consommant davantage d'électricité, donc davantage d'eau en amont. Le dossier qui ne regarde que le site conclut à l'envers de ce qu'il faut faire.
Enfin, rapporter une consommation industrielle aux « besoins en eau » d'une population suppose que les deux soient mesurés de la même façon. Prélèvement et consommation nette ne sont pas la même grandeur, et l'eau prélevée puis restituée au milieu ne manque à personne.
Le carbone d'entraînement : trois nombres, trois statuts
Les 552 tonnes de CO₂e attribuées à l'entraînement de GPT-3 sont publiées, avec leur méthode, dans un article de recherche de 2021 (Patterson et al.). Les 25 000 et 42 000 tonnes attribuées à GPT-4 et GPT-5 sont des estimations de tiers : à notre connaissance, aucun bilan d'entraînement n'a été publié par le fournisseur pour ces deux modèles.
Les aligner en série et en tirer un facteur donne à trois nombres de statuts différents l'apparence d'une même mesure. La tendance est vraisemblable ; le facteur ne l'est pas au chiffre près, et il ne devrait pas figurer dans un document d'entreprise sans cette réserve.
S'y ajoute une question de périmètre que nous avons dû trancher pour notre propre carte d'empreinte : une empreinte calculée de l'extérieur couvre le scope 2 et une partie du scope 3, jamais le scope 1 — ni les fuites de fluide frigorigène, ni le carburant des groupes électrogènes. Ces deux postes ne s'obtiennent que sur le site lui-même. Un chiffre d'entraînement qui ne dit pas son périmètre ne se compare à aucun bilan d'entreprise.
Le point le plus actionnable est le dernier, et c'est celui qu'on cite le moins
« 80 à 90 % de ces impacts viennent de notre usage quotidien. » Autrement dit : de l'inférence, non de l'entraînement. Si cette proportion est juste — et elle est cohérente avec ce que l'on observe dès qu'un modèle sert à grande échelle —, alors la marge de manœuvre n'est ni chez le fournisseur, ni dans le passé. Elle est dans chaque appel, tous les jours, chez celui qui déploie.
Et elle se pilote. Quatre leviers, tous mesurables : le modèle proportionné à la tâche — un grand modèle pour un tri de tickets est le gaspillage le plus courant ; la mise en cache des réponses répétitives ; le traitement différé de ce qui n'est pas urgent ; la requête bornée, c'est-à-dire le contexte élagué.
Ce que CONSEILPREV met à disposition
Le registre des systèmes d'IA de la plateforme Sentinel porte déjà l'attribution que cette démarche réclame : responsable, propriétaire métier, service, finalité. Un module de FinOps de l'IA y ajoute, pour chaque système, le modèle employé, l'unité de facturation, les volumes du mois et leur source, le centre de coût, la classe de tâche et les leviers réellement posés.
Il applique la règle qui vaut aussi pour cette fiche : il refuse de chiffrer ce qu'on ne lui a pas dit. Un système sans volume déclaré ressort « non instruit », jamais à zéro — parce qu'un total qui tait ce qu'il ignore rassure à tort. Et il signale l'écart entre le rang du modèle et celui de la tâche déclarée sans le trancher : dire « trop gros » supposerait de connaître la qualité attendue et ce qu'une erreur coûte.
Note de méthode
Nous rapportons les chiffres de cette fiche tels qu'elle les publie. Nous n'avons pas pu consulter à la source les publications de 2026 qu'elle cite ; les rattachements proposés ci-dessus — rapport Energy and AI de l'AIE, article de Patterson et al. — le sont à des documents que nous connaissons, et l'écart éventuel avec les éditions 2026 reste à vérifier. Nous relevons par ailleurs que la liste des sources passe de (3) à (5) : une des affirmations n'a pas de référence à laquelle se reporter.
Les repères français et états-uniens cités — Arcep, commission d'enquête parlementaire, Lawrence Berkeley National Laboratory — sont ceux que porte notre propre référentiel, avec leur millésime et leur réserve.
Contact presse — Christophe Cerf · christophe.cerf@outlook.com
Communiqué à vocation informative, ne constituant ni un conseil juridique ni une expertise environnementale. Les ordres de grandeur cités doivent être vérifiés à leur source avant tout usage engageant. Document commenté : « L'IA et l'environnement : ce que je retiens », fiche n°1 de la série « Décrypter l'IA d'aujourd'hui », Jean Ponroy.
Sources
- Energy and AI — Agence internationale de l'énergie, 2025
Le scénario de référence de ce rapport porte la trajectoire de consommation des centres de données à l'horizon 2030. - Carbon Emissions and Large Neural Network Training — Patterson et al., 2021
La seule des trois empreintes d'entraînement citées par la fiche commentée qui soit publiée avec sa méthode. - Enquête annuelle sur l'empreinte environnementale du numériquesans lien — Arcep, 2023 (parc déclarant)
Les valeurs d'eau sur site et en amont sont reprises de notre module `eau_dc`, qui les tient de cette enquête. L'adresse de l'édition exacte reste à joindre. - United States Data Center Energy Usage Reportsans lien — Lawrence Berkeley National Laboratory, 2024
Millésime de données 2023. L'adresse stable de cette édition reste à joindre. - Règlement délégué (UE) 2024/1364 — indicateurs de durabilité des centres de données — Union européenne, 2024
C'est ce texte qui fixe l'eau DU SITE comme indicateur déclaré — d'où le fait que l'amont manque partout. - L'IA et l'environnement : ce que je retiens (fiche n°1)sans lien — Jean Ponroy, 2026
Fiche pédagogique diffusée sur LinkedIn, commentée par ce communiqué. Adresse de publication à joindre.
Les adresses ne sont pas ouvertes pour vérifier qu'elles répondent : un lien mort serait annoncé comme vivant. Les sources sans adresse portent la raison de son absence — une source qu'on ne peut pas joindre est une intention, pas une source.